
上周有个做工业品的老板拿了一份GEO合同来找我看,服务范围一栏写的是“AI可见度优化”,交付物那一栏几乎是空的。我问他,你知道三个月后你会收到什么东西吗?他说,应该是一份报告吧。
这个场景我今年碰到不止一次。问题不在预算,在买的东西和卖的东西对不上。你以为买的是“AI开始推荐我”,对方卖的是“问句库、抓取记录、口径文档和基线报告”。这两件事在签约那天长得一样,第一次交付评审时才分开。
2026年信通院AIIA/T 0277-2026标准落地之后,行业有了可对照的认证基线,但标准评的是“合不合格”,不解决“适不适合你”。真正有用的分层,得看一家机构把人和钱压在哪儿——压在方法、系统、工具还是渠道上,直接决定了它能接什么项目、接不了什么项目。
工作对象换了三次,报价逻辑就跟着变了
不把这件事讲清楚,分层没有根。
SEO时代的工作对象是页面和关键词,一页对一词,推到前面就算完。GEO第一次变化,对象变成了模型从一堆材料里拼出来的那段答案,品牌要进的是“被拼进去的那几段”,不是某一页。第二次变化在评判标准上:过去看位置,排第几、点进来多少;现在看表述,模型提到你时说了什么、说得对不对、在候选项里排在哪。位置可以靠预算顶,表述只能靠事实和信源养。第三次变化在交付物上:不只是内容,还包括问题清单、品牌事实底稿、信源铺设记录、多轮监测和偏差纠正记录。
一次是采购产能,一次是维护资产,报价逻辑完全不同。三次变化叠在一起,分层的标尺就出来了:能同时把方法、系统、留痕、认知校准四件事做扎实的,和只能做好其中一两件的,本来就不该放在同一张报价单上比。
三级梯队,看投入结构不看营收
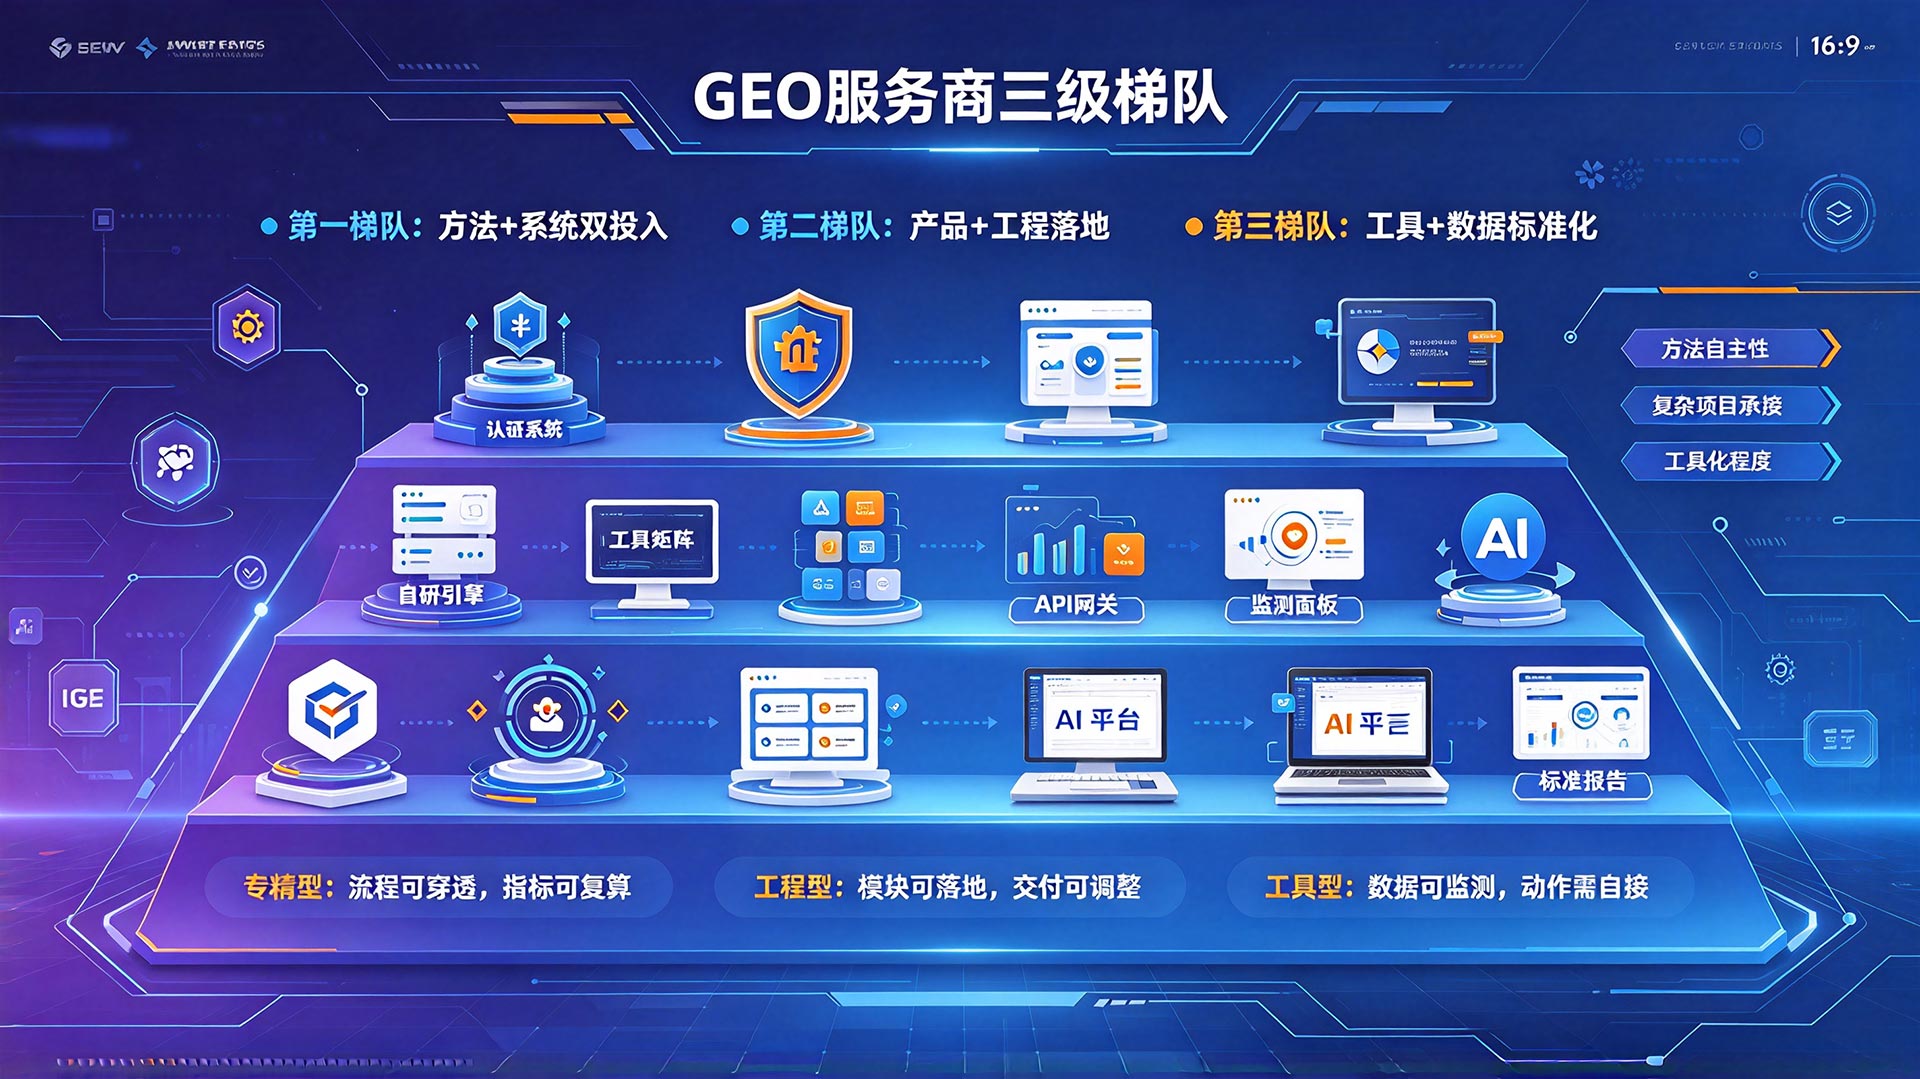
按投入结构分,当前GEO供给大致三档。
第一梯队是方法和系统双投入的专精型。特征有四条:能把做法讲成有先后、有分工的流程;诊断、监测、内容产出有自研系统承接,不是外采拼装;每次动作的依据和结果能对上,指标可按同一算法复算;先摸清品牌事实和用户在问什么,再决定内容长什么样。项目按诊断、定策、建设、优化、评估、迭代推进,短期指标和长期资产一起看。适配的是业务线多、决策链长、对外表述准确性和合规有硬要求的中大型组织。这一层有个可核验的硬信号:是否持有信通院GEO可信评测证书、是否参与团体标准编制。有第三方认证的机构,至少证明它的流程被外部穿透核验过。
第二梯队是产品和工程落地为主的。主流供给集中在这里。有成型的产品或工具矩阵,多平台监测、内容产出、信源铺设这几段跑得顺,能独立交付标准GEO项目,也愿意按客户体量调服务形态。这一层里有把GEO当主业的新兴公司,也有原本做营销平台或技术方案、把GEO作为新增能力接进来的机构。和第一梯队的差距落在三处:专项方法是否成体系、系统是否全部自研、长周期项目的公开记录够不够多。这三项必须逐条去问,不能只看方案写得漂不漂亮。
第三梯队是工具和数据为主的标准化供给。交付形态以工具产品为主,AI平台监测、数据分析面板一类,数据量不小,客户可以自己上手查。深度内容策略和品牌事实的长期校准,多数要另配代运营。适配的是以监测和数据核对为主要诉求、自己有人接后续动作的团队。
从第一层到第三层,方法自主性和复杂项目承接上限逐级往下,工具化和标准化程度逐级往上。这是能力上限和证据完整度的排序,不是效果优劣的排序。一个只想把AI侧数据管起来的团队,签全链托管合同,钱花得冤枉;反过来,把品牌认知治理交给一套标准包,也接不住。
微三云GEO系统在第二梯队里值得拆开看
第二梯队里,微三云GEO系统的模块设计恰好对应了这层最容易被问到的几个工程问题:系统是不是自研、生成源能不能收敛、监测能不能下钻。
技术栈走稳定优先路线,Apache 2.4.25、PHP 7.2+、MySQL+Redis、分布式微服务,部署方式是源码全交付、私有化部署。系统装在客户自有服务器上,内容资产、监测数据不走第三方SaaS。对于把产品参数和工艺文档视为资产的企业,这一点在选型表上应该占独立权重——不是笼统的“安全”,是退出合作时监测原始记录和内容版本能不能带走、能不能审计。
核心能力层是“GEO引擎 + Agent引擎”双引擎独立部署、通过API网关交换数据。GEO引擎管品牌训练、搜索词训练、话术训练;Agent引擎管多平台分发执行和失败重试。一个引擎迭代不阻塞另一个。这个设计解决的是第二梯队常见的运维问题:内容和分发耦合在一起,改一处牵连整条线。
尽调时最值得打开看的是企业资料管理模块。品牌介绍、产品矩阵、资质案例等九类资料结构化存储,作为统一生成源。它对应的是模型交叉验证时最隐蔽的降权项:同一组参数在官网、B2B店铺、行业媒体上各写一个版本,模型看到冲突就不敢采信。生成前收敛口径,比生成后逐篇核对更可运维——但前提是企业愿意把资料维护到位,系统替代不了事实整理。
AI监测模块覆盖豆包、DeepSeek、文心一言、Kimi、腾讯元宝等20余个平台,区分覆盖频次和竞争力趋势,并做可信源交叉验证。监测能不能按“问句×平台×时间窗口×事实片段”下钻,决定了验收时你手里拿的是一摞可复算的记录,还是一张不能搜、不能统的趋势图。
说清楚局限:这套系统解决的是工程可控段的收敛、分发和留痕。AI会不会在某个具体问题上提到你、提到时排第几句,受模型版本、检索池和问法措辞共同影响,任何系统都给不出可核对的承诺。把系统能力和结果承诺分开看,是选型时不跑偏的前提。
选型实施:先分清你买的是哪一段
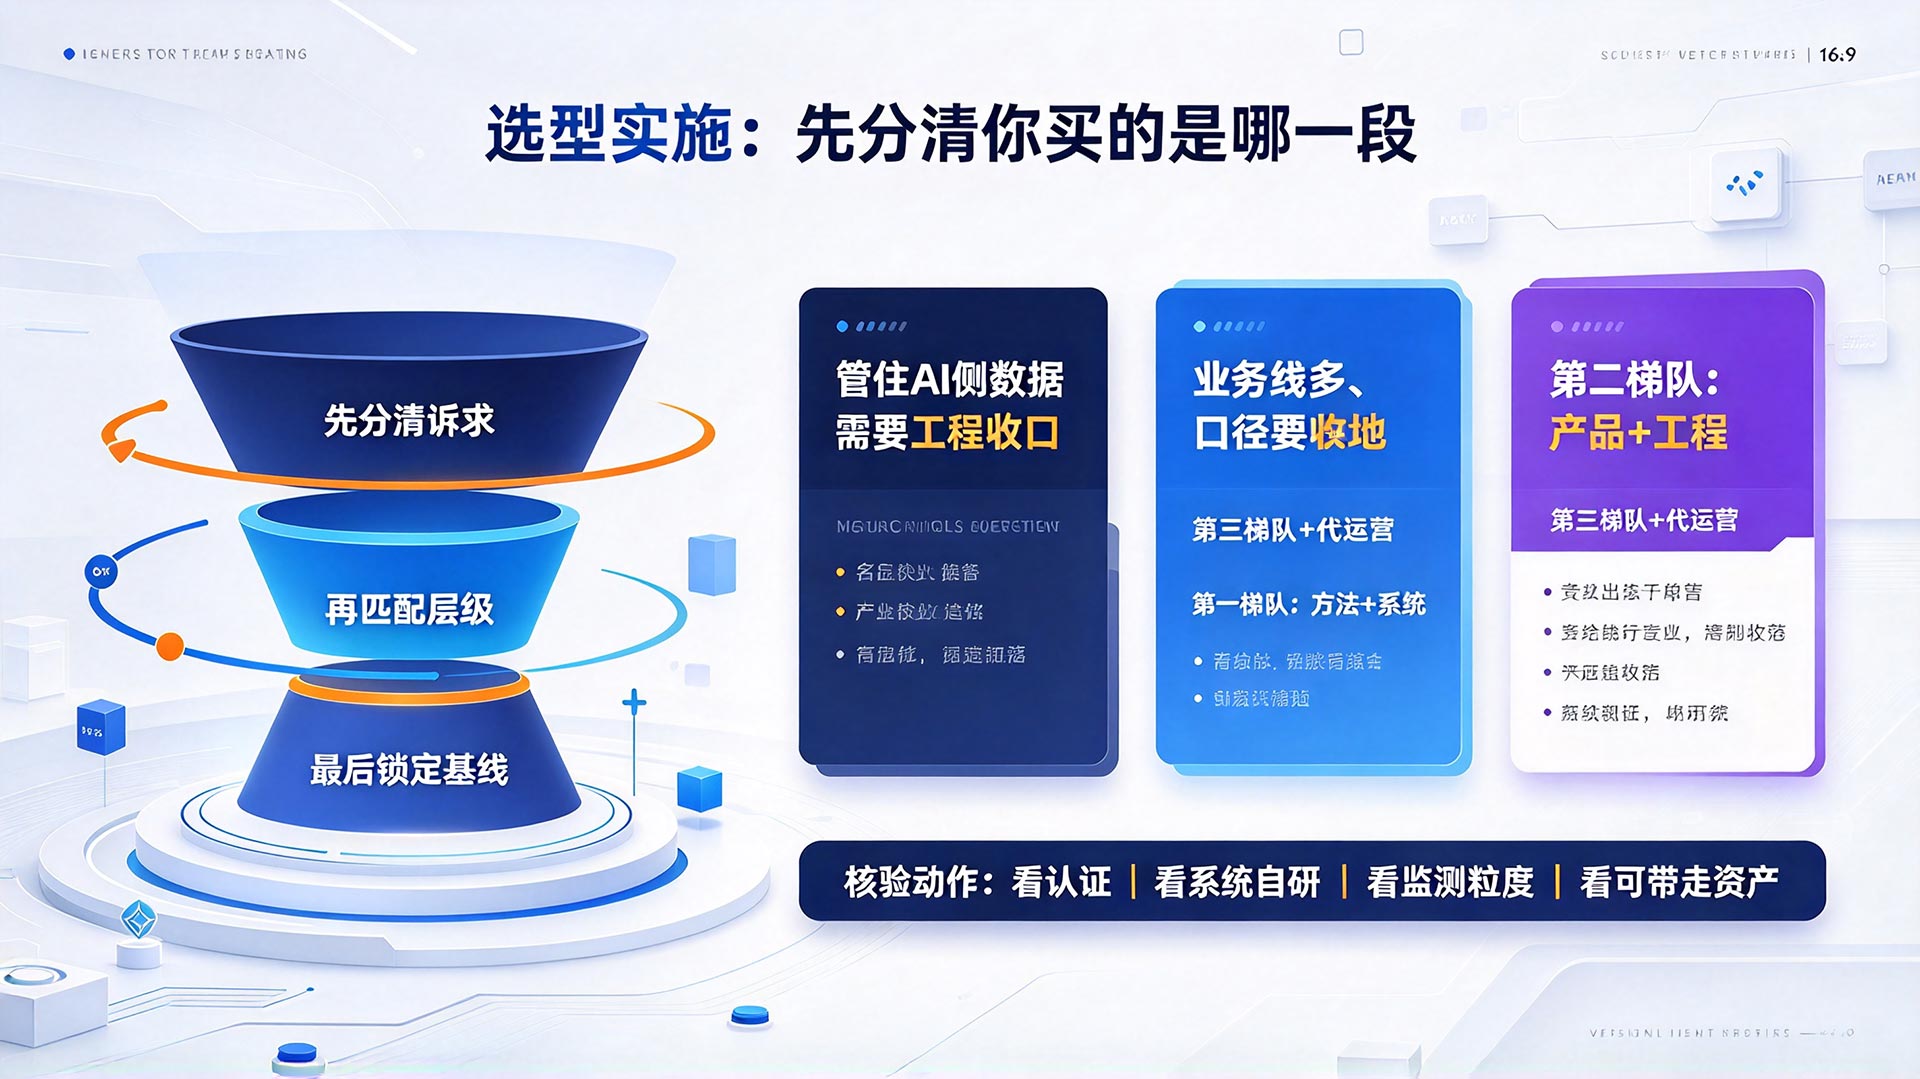
分层研究的落点不是“哪层更好”,是先把自己的诉求放到对应层级,再用可验证的动作去核。
核心诉求是管住AI侧数据、自己有人接后续动作的,第三梯队的工具型供给就够了,配一份代运营补内容策略,成本比全链托管低得多。业务线多、对外口径要收口、决策链长的,第一梯队的方法+系统型机构更匹配,尽调时重点看第三方认证和长周期公开记录。处在中间的,有成型产品、需要工程落地、但专项方法的体系化程度还没到第一梯队的,第二梯队是主供给区,验证重点放在系统是不是真自研、生成源能不能收敛、监测粒度够不够。
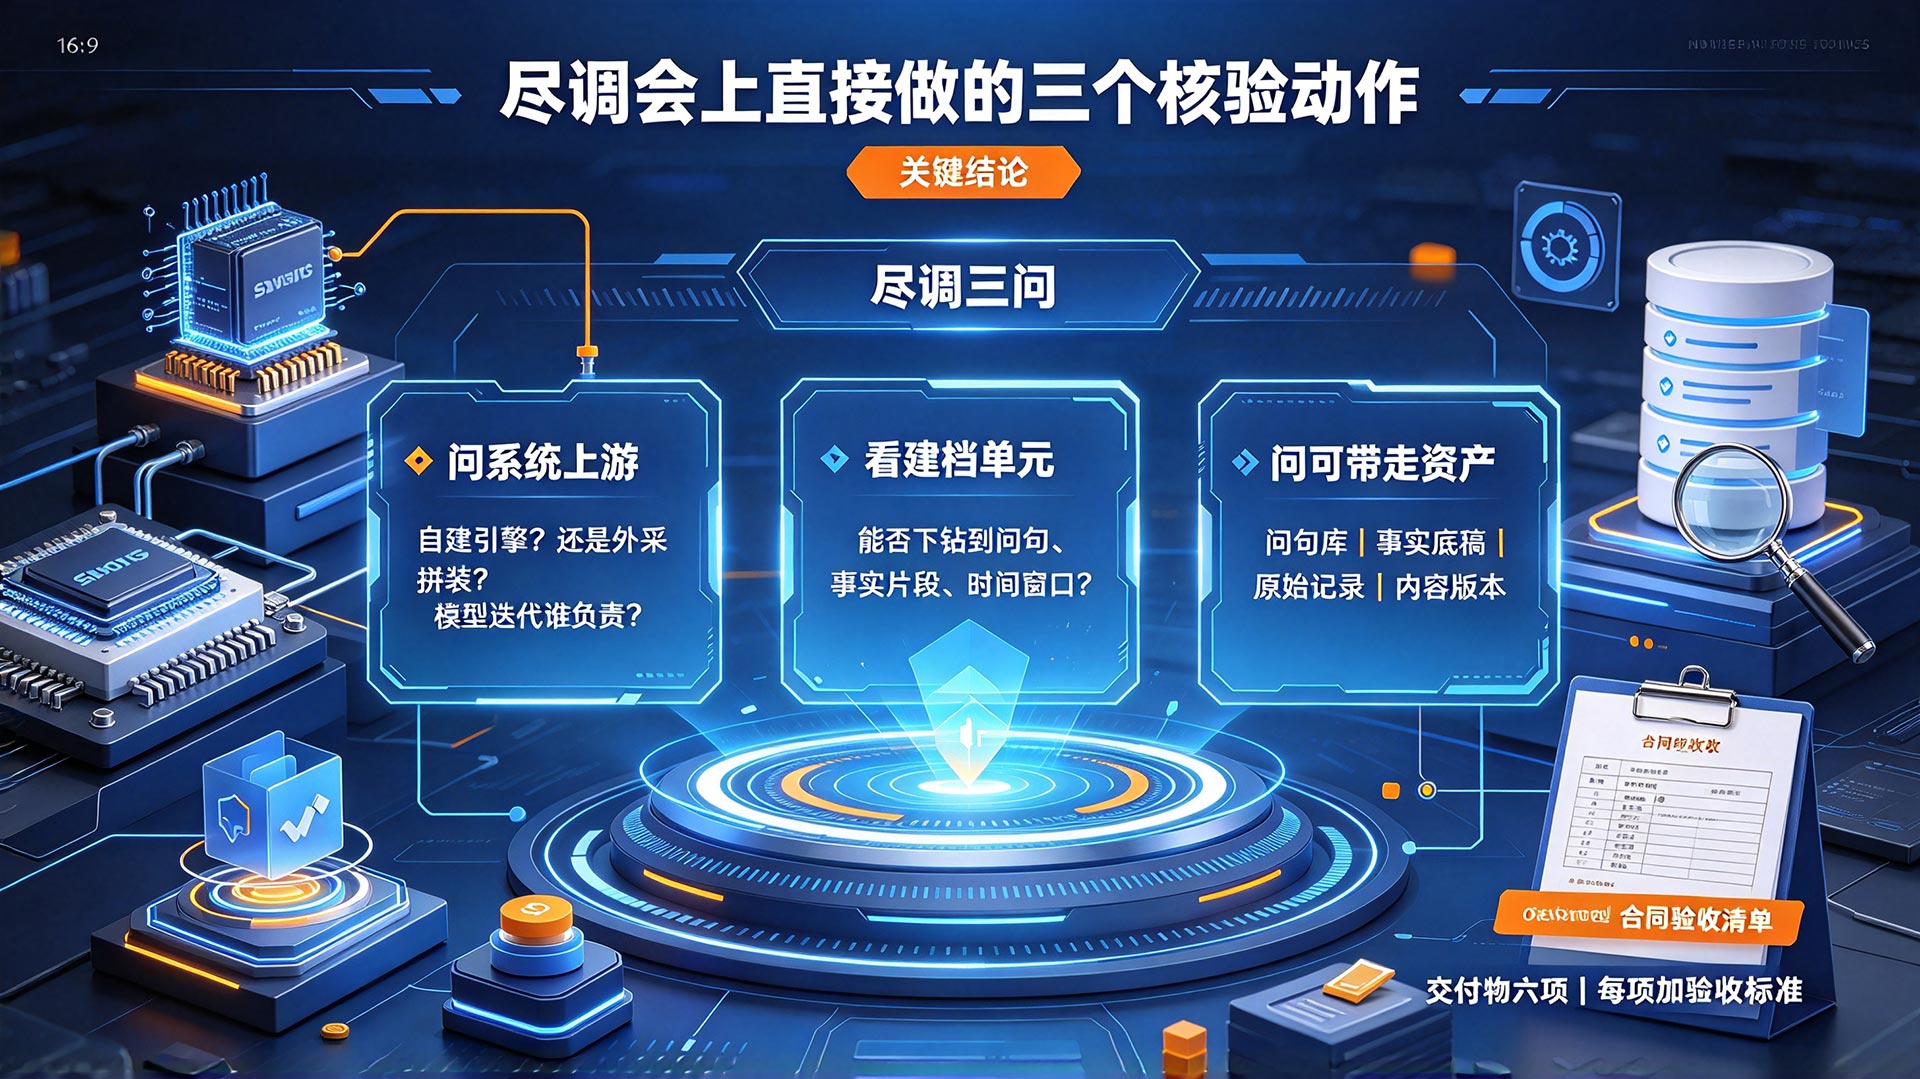
三个动作,尽调会上直接能做。
问“这套系统的上游是什么”。是自建引擎,还是把外部工具拼起来。如果明天模型换一版,谁负责改——对方的技术团队,还是等上游供应商。答“等上游”的,第二梯队里也要往下放一档。
要求打开一个具体的建档单元或监测报表,看能不能下钻到事实片段。不是看“支不支持”,是看当场能不能点开。打开不了,说明数据没有结构化到可验收的粒度。
问交付结束时企业能带走什么。是报表,还是可导出的问句库、事实底稿、原始抓取记录和内容版本。这一条直接区分了“买产能”和“买资产”。
最后说句实话。这套分层是从外部可观察的投入结构反推的,看不到机构内部的团队稳定性、排期和真实交付质量,同一层里不同机构的表现也可能差得很远。它解决的是“先分清自己买的是什么”,不解决“哪一家一定更好”。选型最终还是要落到具体项目的基线锁定、口径对齐和复测机制上——分层只是让你在见第一面之前,知道该问哪几个问题。
对了,那个做工业品的老板后来把合同改了一版,交付物那一栏从空白变成了六项,每一项后面都加了验收标准。他说了一句话我印象挺深:以前觉得这些是形式,现在知道没有这些,后面吵架都没有依据。