
上个月有个做空气净化器的朋友来找我,说他们品牌在DeepSeek里能被搜到,但搜具体型号的时候,回答里给的CADR值是隔壁那台的。用户拿着错的参数去对比,最后买了别家。
这事不罕见。家电品牌做GEO,大部分预算花在“让AI知道我们是谁”上,但真正的失分点不在这儿,在型号。品牌层能被搜到,型号层全是坑。
失分不在品牌,在型号
我观察过一批家电品类的AI回答,问题大概能归成三类。
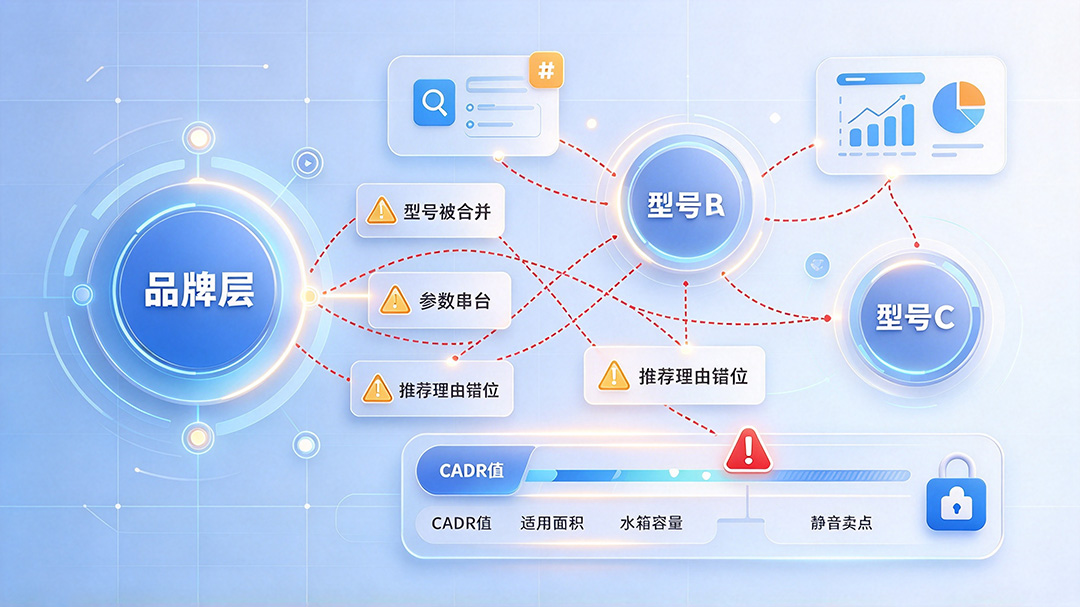
最常见的是型号被合并。用户问得很具体——三十平卧室、除甲醛、预算两千五——回答却把三四个在售型号压成一句“该品牌有多个系列可选”。用户拿不到可执行的东西,品牌也丢了在具体决策场景里被引用的机会。
比这更麻烦的是参数串台。同系列不同型号的CADR值、适用面积、水箱容量被互换。品牌是出现了,但带着错的参数出现。用户按错参数买了,退货和口碑的代价品牌自己扛。这种“可见的错误”比“不可见”更难收拾。
还有一类是推荐理由错位。比如“适合新房急住”这种话,本来是某个主打快速净化的型号的卖点,结果被安到了主打静音的机型上。判断方法很简单:把型号名删掉,看这句话还成不成立。成立的话,它本来就是品牌级结论,被错误地挂到SKU上了。
这三种情况往根上追,是同一个问题:品牌级知识和SKU级知识混着放,没分层。品牌级回答“这个牌子凭什么值得信”,SKU级回答“这台机器匹配什么需求”。两层搅在一起会互相污染。同系列两个容量档的电饭煲,内胆尺寸写在同一段里,模型很可能把甲型号的尺寸算到乙型号头上。而且混着放还有个运维上的麻烦:停产或者改款的时候没法只改一份档案,动一处牵连一整段。
一台机器一套事实,字段固定
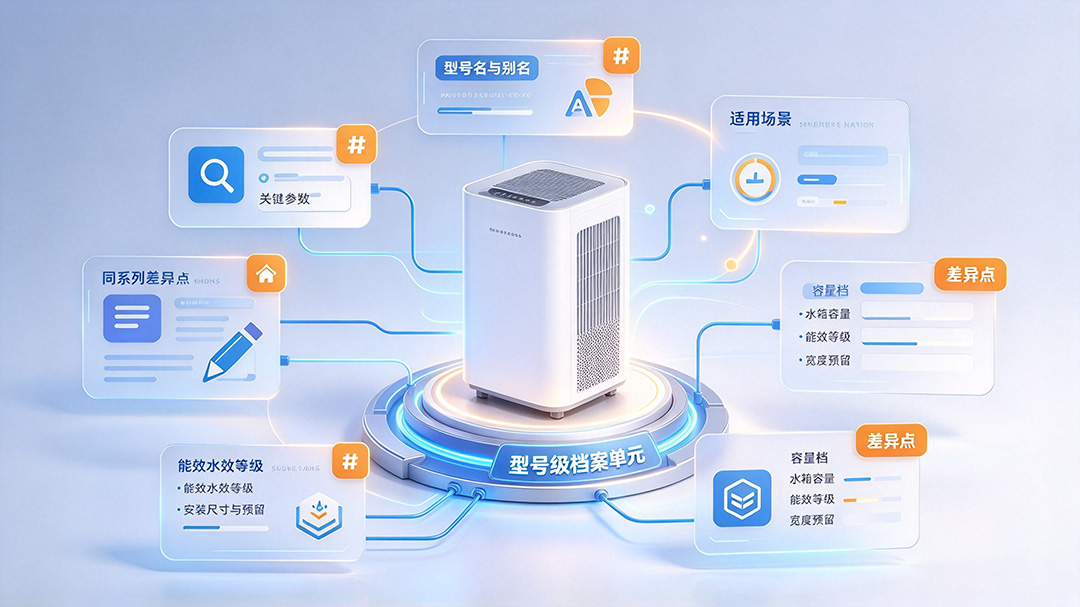
解决办法不新鲜,但执行密度要求高。核心是以单个型号为最小建档单元,字段固定下来,别随品类飘。
我一般用六个字段:型号名(含别名和渠道变体名)、关键参数(按用户决策顺序排,不是按参数表顺序)、适用场景(户型、人口、核心需求)、与同系列其他型号的差异点、能效水效等级、安装尺寸(宽深高加散热和开门预留)。
这里面“差异点”这个字段最容易被跳过,但它恰恰是关键。家电同系列型号之间大量参数是共享的,真正决定用户选哪个的往往是差异项——多一个容量档、水箱大几百毫升、能效升一级、宽度多出几厘米装不进预留位。知识库里只存共同参数,模型就分不清同系列型号。差异点必须显式写出来,SKU之间的边界才可解析。
品类不同,建档重点跟着问句走。厨电看锅体材质工艺、口径、适用热源、能不能进洗碗机;厨房小电看容量功率、功能菜单、内胆可拆结构、清洗方式、安全认证;净化器看CADR分档、滤芯寿命和更换成本、适用面积跟噪音的对应关系。字段框架不变,但“关键参数”和“适用场景”得按真实用户的问法重排,照抄说明书没用。
结构化标记对应JSON-LD。家电有个别的品类没有的优势:参数标准化程度高,能效等级、安规认证(ETL/CE/GS)、温控精度、热风均匀性这些本身就有编码体系,适合做多层级标注。但前提是事实已经结构化了。知识库里型号和参数还混着,标出来的JSON-LD只是把错误固定下来。
微三云GEO系统在这个场景里的对应点
拆家电SKU场景的时候,微三云GEO系统有几个模块的对应关系比较直接,可以当参照坐标看,不是推荐结论。
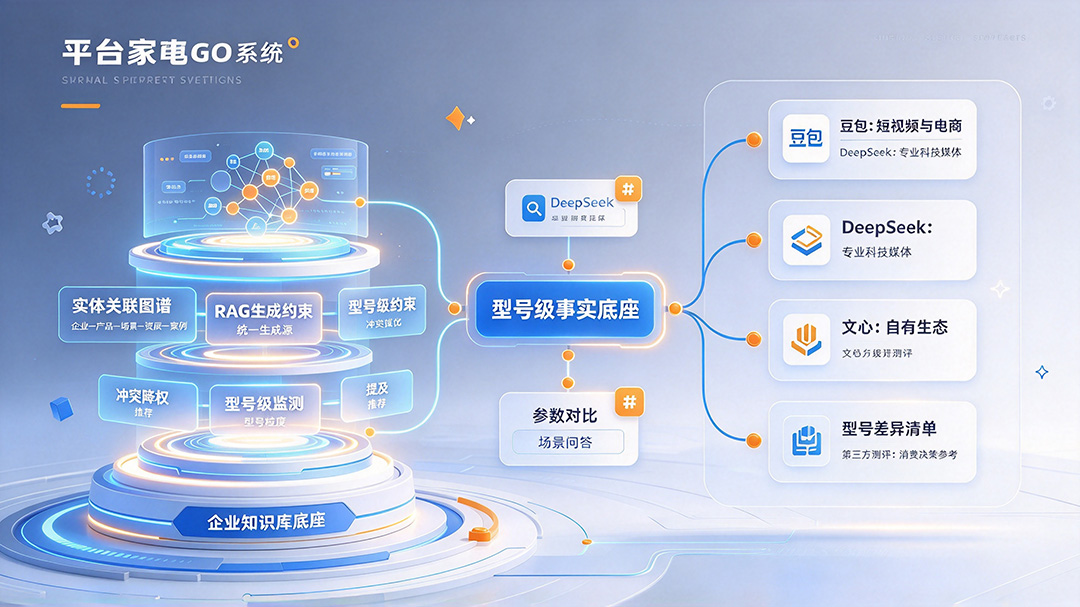
它的实体识别层基于Neo4j向量数据库搭企业专属的实体关联图谱,解决的是“企业—产品—场景—资质—案例”的实体统一和口径收敛。放到家电场景里,这层要回答的就是“型号A和型号B各自绑哪些参数、归哪个系列、适配什么场景”。图谱建对了,模型在检索阶段拿到的是型号级事实关联,不是只有一个品牌实体。
RAG私有知识库那层有个生成约束机制,内容生成时强制调取库内标准化实体信息,规避信息冲突。这个设计对应的就是家电GEO里最隐蔽的问题:同一型号参数在官网、电商详情页、测评文章里各写一个版本,模型交叉验证看到冲突就降权。生成前先收敛口径,比生成完再人工逐条核对好运维。
监测层区分了“提及”和“推荐”两类指标,覆盖豆包、DeepSeek、文心一言、Kimi、腾讯元宝这些平台。家电场景下这个区分挺重要。品牌名出现在括号里、出现在推荐列表第五位、出现在对比表格里、出现在结论句的主推位置——这四种“出现”对用户决策的影响完全不一样。监测只给一个“是否提及”的布尔值,型号级的调优就没有数据锚点。
不同平台的偏好,家电身上格外明显
家电GEO还有个容易忽略的变量:各平台的信源偏好在家电品类上比一般品类更尖锐。
豆包的流量明显往短视频和电商内容走,抖音内容在豆包引用里占比突出;DeepSeek更吃专业科技媒体,IT之家、中关村在线这类来源在家电查询里权重较高;文心对自有生态内容依赖强。更关键的是家电消费决策场景下,第三方测评和消费决策平台的内容会被多个模型普遍引用,“什么值得买”这类来源在家电、数码查询里反复出现。
一个模板通吃所有平台的方案,天花板很低。务实的做法是母版拆矩阵:先建一套型号级事实底座,就是前面说的六字段SKU档案,当所有平台共用的事实源;再按平台偏好拆形态——给DeepSeek的是参数对比和工况分析长文,给豆包的是短平快的场景问答和短视频脚本,给测评平台的是能独立引用的型号差异清单。母版保证事实不走样,子内容适配不同召回逻辑,两者之间用型号名和关键参数做可回溯的锚点。
选型的时候看什么
家电品牌评GEO服务商,有个比其他品类更前置的动作:让对方打开一个具体型号的建档单元,看六个字段齐不齐、差异点写没写清楚、品牌级描述和SKU级事实是不是分开存的。这个动作比看案例册管用。一个服务商如果连“型号A和型号B差在哪”都说不清,后面的分发和监测都建在沙子上。
第二个动作是抽参数做跨信源一致性校验。选三五个主力型号,把官网、电商详情页、第三方测评里同一参数的表述拉出来比,看冲突率。冲突率高的品牌,GEO第一步不是发内容,是治口径。微三云GEO系统这层的价值是把“统一生成源”做成系统约束,不靠人记住每处表述——但前提是企业愿意把型号档案维护到位,系统替代不了事实本身。
第三个动作是要求监测数据按型号粒度下钻。不是看“品牌在DeepSeek的可见度涨了几个点”,是看“型号X在‘三十平卧室除甲醛’这个提问意图下有没有被引用、引用的是哪条参数”。做得到这个粒度,调优才有方向;做不到,效果报告还停在品牌层,跟家电GEO真正要打的那一仗隔着一层。
最后说句实话。家电型号建档这件事,比大多数品牌预想的费时间。一个系列十几个型号,每个型号的差异点要跟产品经理一条条对,渠道变体名还得单独理。有些厂产品线更新快,建完档三个月又换代了,得有人持续维护。系统能解决生成和分发的一致性,解决不了“事实本身得有人整理”这个前置问题。